
用 OpenWrt + Tailscale 打通内网:让云服务器访问内网 API
代码和自动化脚本都跑在云服务器上,要调用的 API 却只能在内网访问。每次用它,都得把任务搬回本地,临时切换运行环境,来回折腾。
这次我想解决的,就是这个问题:保留现有路由器配置,不申请公网 IP,让云服务器通过一条专用网络通道访问内网服务。
最后,我把 Tailscale 装在内网的 OpenWrt 路由器上,让路由器承担子网转发;云服务器也加入同一个 Tailscale 网络,通过它访问内网 API。API 服务器本身不用安装 Tailscale。
配置步骤不算多,真正花时间的是排错:节点已经在线,后台也批准了路由,请求却还是超时。
下面按实际配置顺序,记录安装、路由审批、防火墙转发和两处排错经历。每一步都附上检查方法,方便区分“节点在线”和“请求真正走通”。
本文根据一次实际配置记录整理。目标域名、目标 IP 和设备名称使用示例值,操作截图中的账号等信息已作脱敏处理。示例适用于自有或已获授权管理的网络;涉及单位内部服务时,先确认远程接入和使用范围。文中的历史输出来自当时记录,补充的检查命令与修订示例不代表已在其他设备上实测。
一、先明确:要打通的是哪一段网络
用下面这组地址说明需求:
- 内网 API:
https://aiapi.example.com,目标地址为10.20.30.40。 - OpenWrt 路由器:处在能够访问该 API 的网络中。
- 云服务器:Debian 12,日常运行代码和自动化任务,但原先无法直连这个内网地址。
这里最关键的前提,是路由器自己已经能访问目标服务。Tailscale 负责把云服务器的流量送到这台路由器,后半段仍然依赖原有网络。
当时环境不具备可用的公网入站条件,所以没有采用端口映射,而是让内网侧设备主动建立连接。CGNAT 是这类限制的一种常见原因,但不能只凭一次 traceroute 或一个脱敏地址就断定它的存在。本文的 203.0.113.45 是文档示例地址,不应拿它当作真实的 CGNAT 证据。
为什么选择 Tailscale
如果只需要暴露某个服务,反向代理或 frp 也可以考虑;frp 并非只能映射一个端口。我选择 Tailscale,主要是希望云服务器继续使用目标内网 IP 和原域名,尽量少改现有程序。
Subnet Router(子网路由器)允许一台加入 Tailscale 的设备,转发发往指定网段或单个地址的流量。目标 API 服务器本身无需安装 Tailscale。
这次只需要一个目标,所以宣告 10.20.30.40/32,不用把整个 10.0.0.0/8 都带进来。/32 表示单个 IPv4 地址;能否访问它,还要经过路由审批、客户端设置和访问策略检查。参考 Tailscale 子网路由文档。
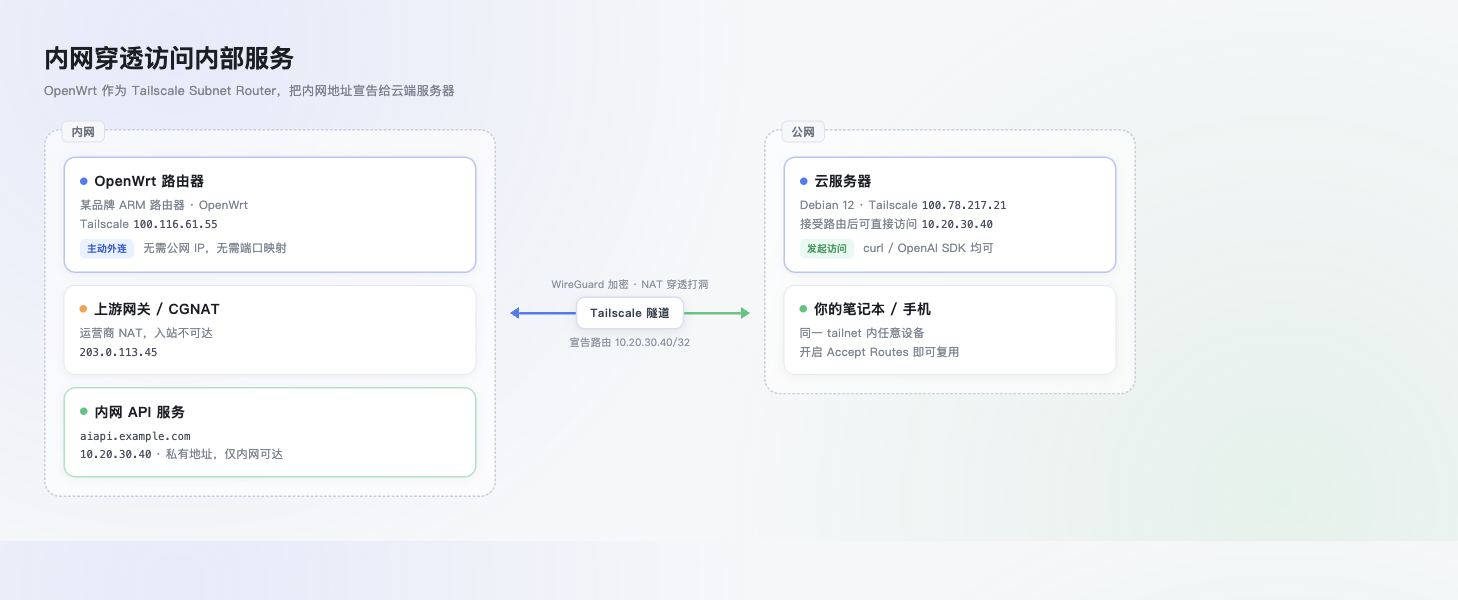
OpenWrt 作为子网路由器连接云服务器与内网 API 的架构示意。
图中为脱敏后的架构示意,公网侧地址仅用于占位。其中“CGNAT”是场景示意,本文未独立验证其成因;“接受路由后可直接访问”“开启 Accept Routes 即可复用”省略了后台审批和访问策略条件,完整要求见第四节。实际请求路径可以理解为:
云服务器上的程序 → 云服务器的 Tailscale 接口 → OpenWrt 路由器 → 原有内网路径 → API 服务网络条件允许时,节点之间直接通信;无法直连时,Tailscale 会尝试通过中继传输。协调服务负责节点发现与连接协调,业务流量不一定经过它。
二、安装前,先看固件和依赖
这次使用一台运行第三方 OpenWrt 定制固件的 ARM 路由器。下面列出当时的环境,方便对照排查,不要求读者使用相同版本:
| 设备 | 记录中的环境 |
|---|---|
| 路由器 | OpenWrt 定制固件,内核 6.12.93,aarch64_cortex-a53 |
| 路由器资源 | 内存约 239 MB,操作前 overlay 剩余约 51 MB |
| 路由器 Tailscale | 软件包截图显示 1.80.3-r1 |
| 云服务器 | Debian GNU/Linux 12,Tailscale 1.104.2 |
先检查 TUN 设备和内核模块:
uname -rls -la /dev/net/tunlsmod | grep tunopkg list-installed | grep kmod-tun当时的输出是:
6.12.93crw------- 1 root root 10, 200 /dev/net/tuntun 45056 0kmod-tun - 6.12.93-1kmod-tun 需要与当前固件的内核构建兼容,除了版本号,还可能涉及内核 ABI 和编译配置。不要看到缺包,就直接从另一套固件的软件源里强装。
这台路由器已经预装了匹配的模块。如果设备没有,应使用对应固件提供的软件源或构建产物。
还要检查路由器是否允许 IPv4 转发:
sysctl net.ipv4.ip_forward子网路由器需要该值为 1。如果为 0,可先用下面的命令临时开启,再按当前固件的 sysctl 配置方式持久保存,并在重启后复查:
sysctl -w net.ipv4.ip_forward=1这里说的是承担转发职责的路由器;只是发起请求的云服务器,不需要为了调用 API 就额外开启 IP 转发。
三、安装 Tailscale,并宣告目标路由
以下命令适用于这次采用 opkg 的固件。先确认软件源属于当前固件,再安装:
opkg updateopkg install tailscale
/etc/init.d/tailscale enable/etc/init.d/tailscale start
tailscale version/etc/init.d/tailscale status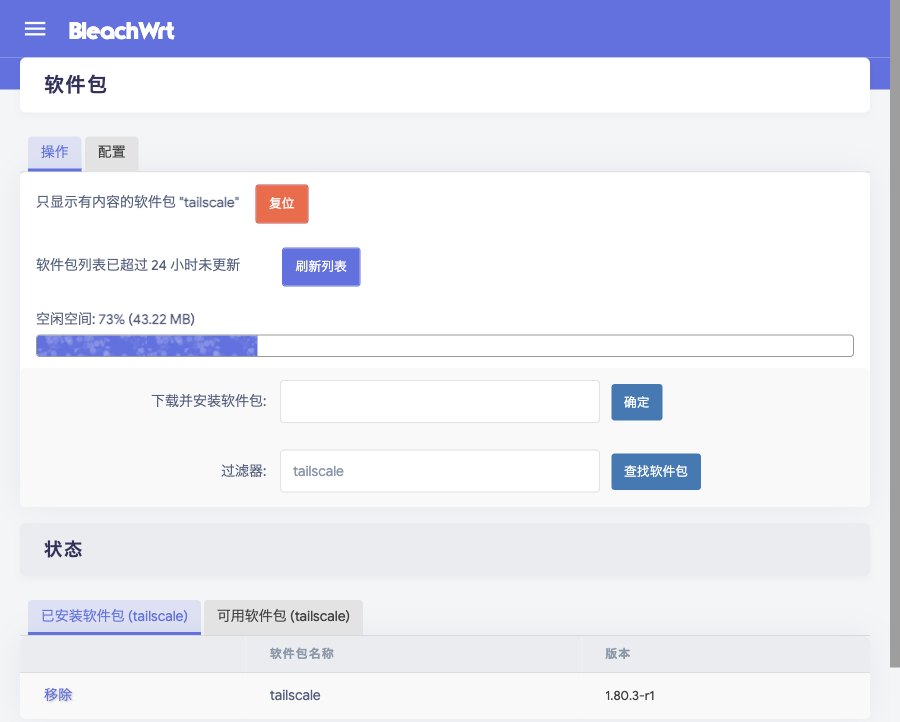
LuCI 软件包页面显示已安装的 tailscale 软件包及版本。
路由器首次加入 tailnet 时执行:
tailscale up --advertise-routes=10.20.30.40/32 --accept-routes=false终端会给出登录链接,在浏览器中完成认证,把路由器和云服务器加入同一个 tailnet。
这两个参数的作用是:
--advertise-routes:声明这台路由器可以转发到目标地址。--accept-routes=false:这台路由器此时不需要接收其他节点发布的子网路由。
如果设备已经加入 Tailscale,只是调整这两项设置,可以使用:
tailscale set --advertise-routes=10.20.30.40/32 --accept-routes=false注意,--advertise-routes 设置的是本机完整的宣告列表。设备已有其他需要保留的路由时,应一并列出,不要直接用这个单地址示例覆盖。
认证后检查:
tailscale statustailscale ip -4节点在线,说明设备已经加入 tailnet。要让请求走通,还得批准路由,并让云服务器接受它。
四、后台批准路由,客户端接受路由
打开 Tailscale 设备管理页面,找到路由器节点。宣告路由后,它会出现 Subnets 标记。
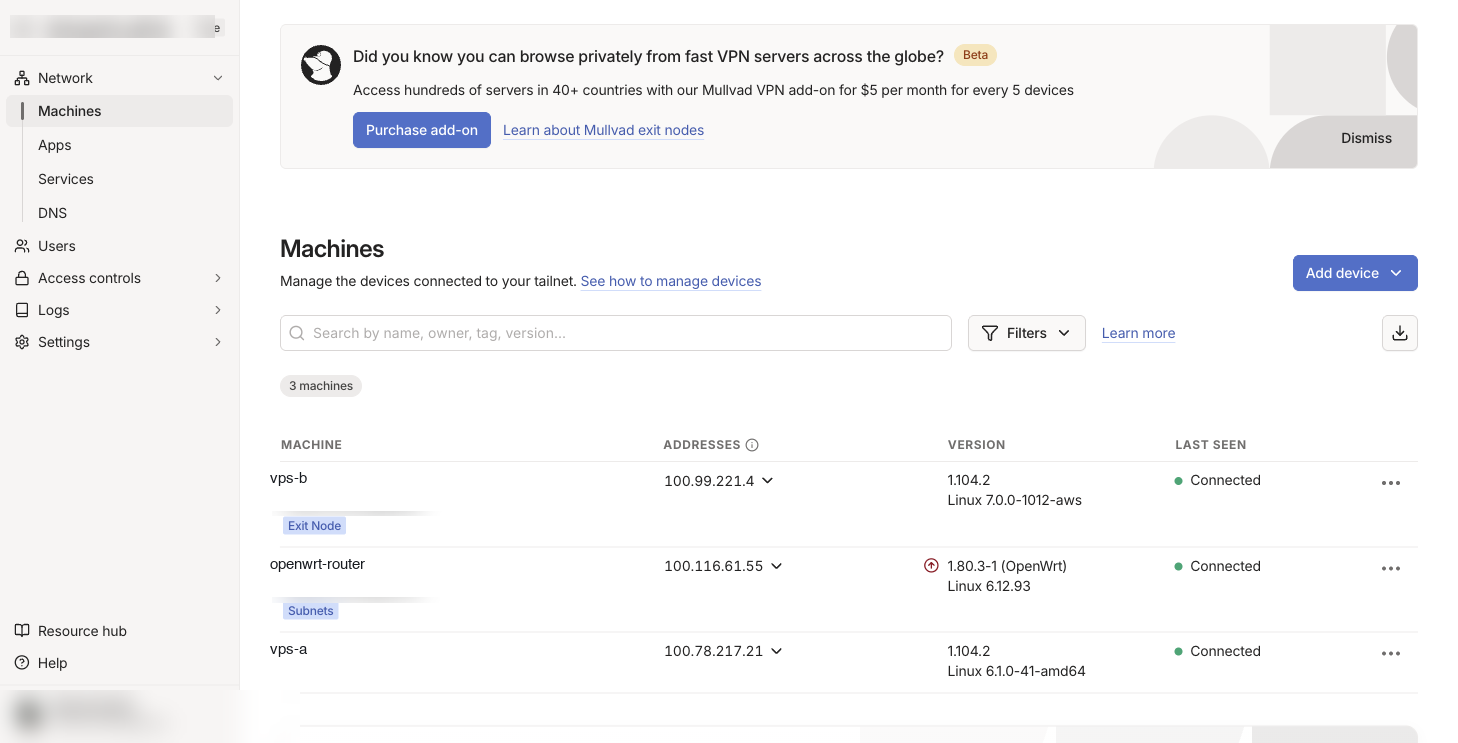
Tailscale 设备列表中路由器节点显示 Subnets 标记。
进入该节点右侧的 ⋯ 菜单,选择 Edit route settings,勾选 10.20.30.40/32,保存。
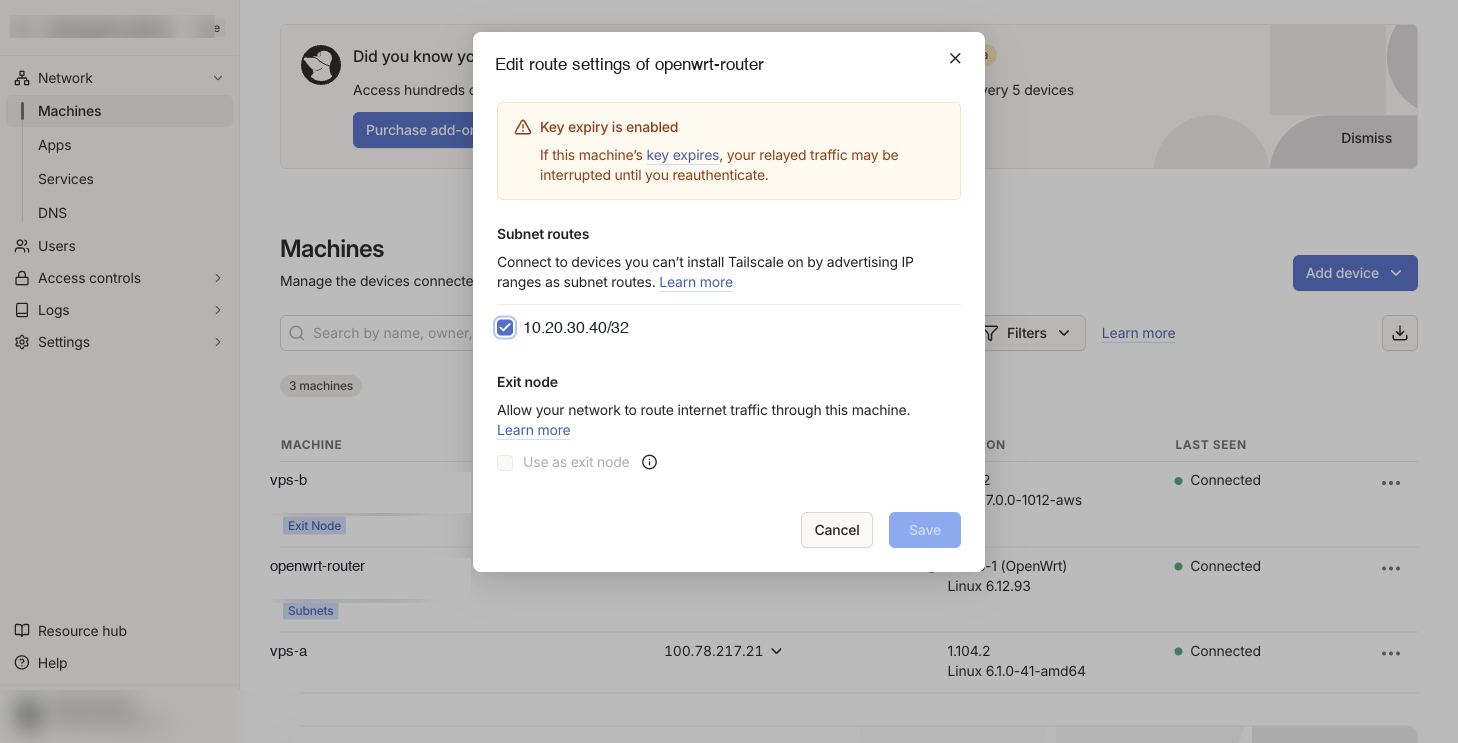
路由批准面板勾选单地址路由 10.20.30.40/32。
如果 tailnet 已配置相应的自动审批规则,处理方式可能不同;这里展示的是手动批准流程。
接着在 Debian 云服务器上开启对子网路由的接受:
sudo tailscale set --accept-routes=trueLinux 客户端需要显式启用这项设置。还要检查 tailnet 的 ACL 或 grants 是否允许这台云服务器访问 10.20.30.40 的服务端口。路由被批准,和用户获得访问权限,是两项独立配置。
到这里,至少要核对四件事:
- 路由器确实能访问目标地址。
- 路由器宣告了正确的路由,后台已批准。
- 云服务器已接受子网路由。
- 访问策略允许这台云服务器连接目标服务。
五、防火墙往哪里转发,要看实际出口
接下来,要让从 tailscale0 进入路由器的流量,能够继续走向目标。
这里容易凭直觉配错:虽然访问的是“内网服务”,防火墙的转发目标却未必是 lan。
先在路由器上查看:
ip route get 10.20.30.40当时的输出是:
10.20.30.40 via 192.168.1.1 dev wan src 192.168.1.110这台路由器通过 WAN 侧的上游网络访问目标,所以当时配置的是 tailscale → wan。如果你的目标在 LAN 侧,区域选择就应随之改变。
配置时,要先确认输出中的设备属于哪个 OpenWrt 逻辑接口和防火墙区域;有的固件显示 eth0、br-lan 等名称,不能直接把设备名当成区域名。
下面保留当时建立独立区域的配置,便于对照截图。这是在可信节点之间排障时使用的较宽放行配置,会允许 tailnet 流量访问路由器本机并转发到 WAN。 正式使用时应结合 tailnet 策略和路由器规则,把访问范围收敛到需要的目标、端口和来源。已有同名区域时,在原配置上修改,不要重复添加。
uci add firewall zoneuci set firewall.@zone[-1].name='tailscale'uci set firewall.@zone[-1].input='ACCEPT'uci set firewall.@zone[-1].output='ACCEPT'uci set firewall.@zone[-1].forward='ACCEPT'uci set firewall.@zone[-1].masq='1'uci set firewall.@zone[-1].mtu_fix='1'uci add_list firewall.@zone[-1].device='tailscale0'
uci add firewall forwardinguci set firewall.@forwarding[-1].src='tailscale'uci set firewall.@forwarding[-1].dest='wan'
uci commit firewall/etc/init.d/firewall restart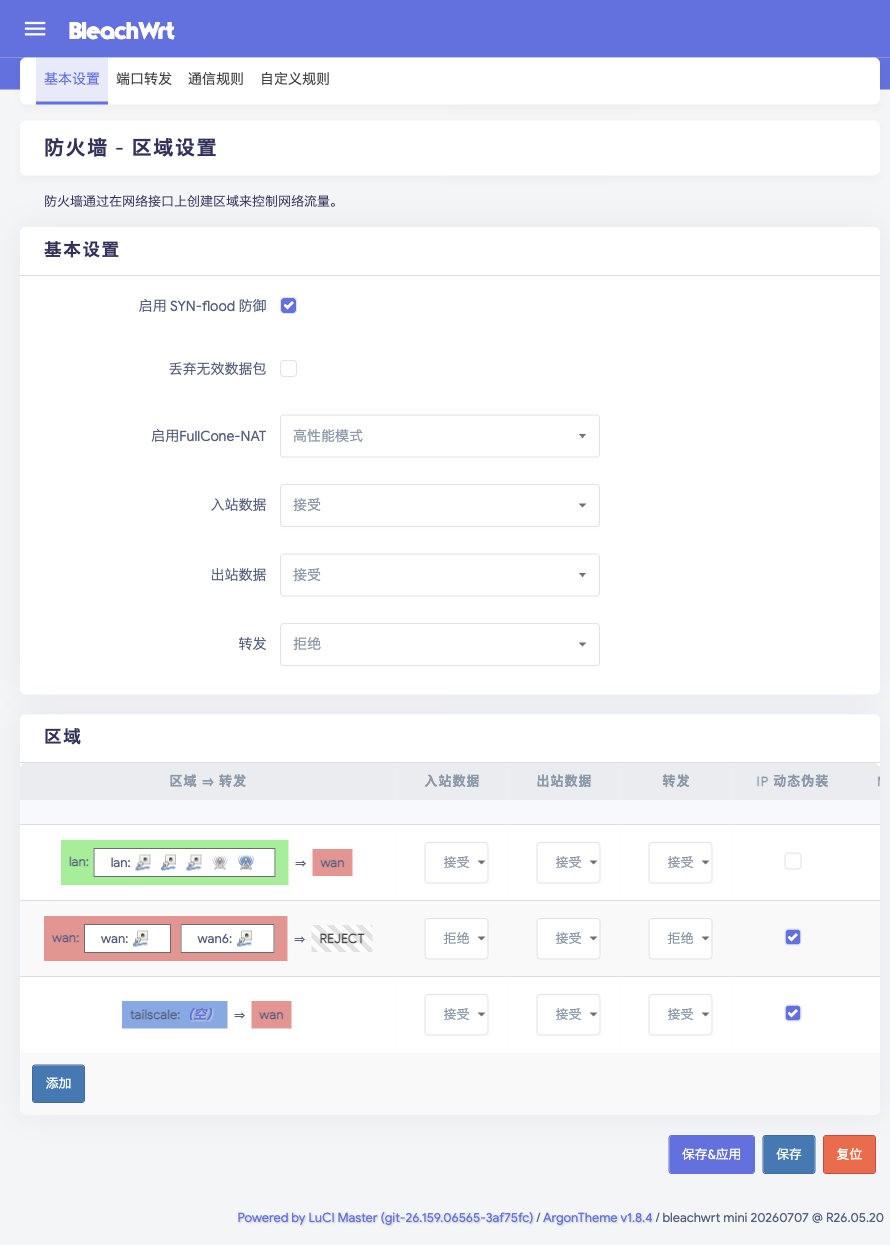
LuCI 防火墙区域页面展示 tailscale 区域向 wan 转发的配置。
其中 masq 作用于该区域对应的出口,不能仅凭这里开启了它,就认定“发往 WAN 的源地址转换已经配置正确”。Tailscale 子网路由默认启用 SNAT,仍应核对实际生效的规则和回程路径;如果主动关闭了 SNAT,目标网络通常还需要知道如何把返回流量送回 tailnet。
修改防火墙可能中断管理连接,操作时保留可用的本地管理入口。
六、节点在线,请求却超时:按两端逐层排查
先分开测试路由器和云服务器
排错时,先确认失败发生在哪一段。
在路由器上,用目标域名发起请求,同时指定它连接到目标 IP:
curl --resolve aiapi.example.com:443:10.20.30.40 \ --connect-timeout 5 --max-time 15 \ https://aiapi.example.com/这比直接访问 https://10.20.30.40/ 再添加 Host 请求头更合适:URL 里的域名同时用于 HTTPS 的 SNI 和证书主机名检查,--resolve 只替换这次请求的解析结果。参考 curl 的 --resolve 说明。
如果路由器可以访问,云服务器不行,再查隧道、路由和转发;如果路由器也不通,先处理原有网络或服务问题。
坑一:软件包选用了当前固件不可用的防火墙后端
这次最有价值的一条线索来自日志:
logread | grep tailscale当时出现了:
firewallmode="nft-forced"health(warnable=router): error: create table: get table: get tables: netlink receive: invalid argument这条日志说明,Tailscale 没能正常建立所需的防火墙规则。于是就出现了一个容易误判的状态:节点在线,转发却不通。
问题出在 nftables 后端建立规则的环节。不过,仅凭这条日志,还无法判断具体是内核能力、模块缺失,还是其他兼容问题。能够确定的是:当时被强制选择的 nftables 后端没有正常工作,切换到该固件可用的 iptables 后端后,相关规则恢复。
这次采用的修复是:
uci set tailscale.settings.fw_mode='iptables'uci commit tailscale/etc/init.d/tailscale restart这项 UCI 配置依赖软件包的启动脚本支持。OpenWrt 的相关软件包启动脚本会读取 fw_mode,再传给 Tailscale;自己的固件是否相同,应查看本机脚本:
grep -nE 'fw_mode|TS_DEBUG_FIREWALL_MODE' /etc/init.d/tailscale不能把这次修复概括成“Tailscale 一律默认 nftables,所有 OpenWrt 都要改 iptables”。后端选择受到版本、软件包和启动环境影响;以本机日志为准。参考 Tailscale 防火墙模式文档。
对于这次使用 iptables 的环境,重启后检查:
iptables -S | grep -E 'ts-input|ts-forward'随后,规则中出现了 ts-input、ts-forward 及对应跳转。如果当前系统本来就在用 nftables,单凭 iptables 查不到这些链,并不能判定故障,应查看对应的 nftables 规则。
坑二:后台显示有路由,本机却没有目标明细
路由器侧处理好以后,云服务器仍然不通。继续查客户端的策略路由:
ip rule showip route show table 52ip route get 10.20.30.40table 52 是这次 Linux 环境中 Tailscale 使用的路由表;它适合作为排错线索,不是所有平台通用的接口。
当时服务器还在使用另一台机器作为 Exit Node,表里能看到默认路由,却缺少目标 10.20.30.40/32 的明细。这里要留意:目标解析成私有地址,不代表客户端就已收到那条子网路由;一条指向 tailscale0 的默认路由,也不能证明选中了目标子网路由器。
重新应用客户端设置后,访问恢复了。但那次操作同时重设了多个参数,无法据此确定究竟是哪一项起了作用。
尤其不能据此得出“Exit Node 会覆盖所有子网路由,必须加 --exit-node-allow-lan-access”的结论。这个开关用于在使用 Exit Node 时保留客户端本地网络的访问,不是接受远端子网路由的开关。参考 Exit Node 的本地网络访问说明。
遇到类似现象,先依次核对路由宣告、后台审批、客户端 --accept-routes 和访问策略,再结合 ip rule 与路由表分析。如果环境还需要保留原有 Exit Node,应记录并保留原设置,避免排错时顺手改变服务器的默认出口。
处理这类问题时,不建议一上来就使用 tailscale up --reset,或添加开机硬补 table 52 的脚本。前者会重置未列出的偏好,后者可能掩盖路由没有正常安装的问题。应先让 Tailscale 自身的配置和路由状态保持一致。
七、最后一段:域名、证书和真实请求
IP 地址能访问后,还要检查程序使用的域名是否解析到了正确地址。
单个固定目标,可以在云服务器的 /etc/hosts 中添加下面这一行;已有同名记录时先检查,避免重复或冲突:
10.20.30.40 aiapi.example.com检查系统解析结果:
getent hosts aiapi.example.com目标 IP 变化时,记得同步更新这条记录。如果需要访问多个内部域名,可以考虑内部 DNS 或分流 DNS,减少逐条维护 hosts 的麻烦。
然后在云服务器上发起请求:
curl --connect-timeout 5 --max-time 15 \ -o /dev/null -sS \ -w 'HTTP %{http_code} | %{time_total}s\n' \ https://aiapi.example.com/api/status路径应换成目标服务实际提供的状态接口。当时使用了关闭证书验证的 curl -k,得到 HTTP 200 | 0.051s;它说明当次请求获得响应,不能同时证明证书验证通过,也不是所有环境下的延迟保证。上面的修订命令保留证书校验,供后续正常使用时验证。
如果服务使用私有 CA,应安装受信任的 CA 或通过 --cacert 指定它,而不是把 -k 一直留在正式调用里。
再用 tailscale status 查看当前连接状态:
tailscale status当时,对端显示过 active; direct ...:41641,说明那次连接建立了直连;出现 relay 则表示相应连接走中继。一次直连不能保证以后一直直连,请求总耗时也不能直接当作隧道往返延迟。
把调用放回原来的程序
网络、域名解析和 TLS 都正常后,就可以把调用接回原来的程序。下面是 OpenAI 兼容接口的 curl 示例,模型名、路径和凭据以实际服务为准;API 自身的认证仍然需要保留:
curl https://aiapi.example.com/v1/chat/completions \ -H "Authorization: Bearer $API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "your-model", "messages": [{"role": "user", "content": "你好"}] }'这里的 $API_KEY 从运行环境读取,不要把真实令牌写进文章、截图或可公开的脚本。
八、保存配置,检查重启后的可用性
路由器侧确认 Tailscale 已启用开机启动,UCI 修改已经 commit,客户端设置和认证状态保存在持久存储中。
云服务器侧确认 tailscaled 自启动、已开启 accept-routes,hosts 或 DNS 设置仍然有效。本文没有执行新的重启测试;实际部署后,应在可恢复的条件下分别重启两端,重新检查服务、路由和请求。
后台截图里还有一条 Key expiry is enabled 提醒。无人值守的子网路由器需要安排设备密钥到期后的维护;如果决定关闭该节点的密钥过期,要同时做好设备管理和失窃后的撤销。不要把认证密钥和 API 令牌混为一谈。
九、这次排错,最值得留下的是什么
| 现象 | 优先检查 |
|---|---|
| 路由器自己也访问不了目标 | 原有网络路径、域名解析、目标服务 |
| 节点在线,但流量不通 | 路由审批、客户端接受设置、访问策略 |
| 转发区域配置了却不生效 | 目标实际出口,以及设备对应的防火墙区域 |
| 日志出现 nftables 建表错误 | 固件能力、启动脚本选择的后端、实际规则 |
| 路由表有默认路由,却没有目标明细 | 宣告与审批是否一致、客户端策略路由 |
| IP 可通,域名请求失败 | DNS、hosts、HTTPS 的 SNI 和证书信任 |
| 过一段时间突然失联 | 节点在线状态、密钥有效期、网络变化 |
这次最容易走弯路的地方,是把几个层面的“成功”混在了一起。安装完成、节点在线、路由宣告、后台批准、客户端接受、转发放行,直到请求返回,每一步都要分别验证。
我后来更愿意按这个顺序查问题:先确认路由器到目标,再确认云服务器到路由器,最后看域名和应用请求。 每次只缩小一段范围,比反复重启服务、一次改好几个参数,更容易找到原因。
这套方案给我的方便很直接:任务继续留在云服务器上,内网的 OpenWrt 路由器负责转发,程序沿用原来的域名和调用方式。以后再遇到访问失败,也能沿着这条路径逐段检查。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
